Ein Modell statt vieler Werkzeuge
Standorte, Leitungen, Materialgesetze, Wetter und gelernte Zusammenhänge stehen im selben Modell. Eine Kalibrierung, eine Optimierung und eine Risikokennzahl greifen auf dieselbe Rechnung zu.
Geometrie, Physik und Unsicherheit eines Problems werden ein einziges Python-Modell. Sie simulieren es, kalibrieren es an Messungen und optimieren eine Auslegung mit demselben Gradienten, und jede Zahl kommt mit ihrem Fehlerbalken zurück.
Standorte, Leitungen, Materialgesetze, Wetter und gelernte Zusammenhänge stehen im selben Modell. Eine Kalibrierung, eine Optimierung und eine Risikokennzahl greifen auf dieselbe Rechnung zu.
Unsichere Größen wie Windrichtung, Last oder Materialfestigkeit gehen in die Physik ein und werden durch sie hindurch propagiert, nicht als Rauschen an das Ergebnis angehängt.
Monte-Carlo-Fehler, Parameterintervalle, Extremrisiken wie VaR und CVaR, Sensitivitäten und Validierungsmaße werden mitgeliefert, zusammen mit einem Protokoll, wie jede Zahl entstanden ist.
Bausteine für Modellierung, Kalibrierung, Optimierung und Risiko. Jede Karte öffnet das passende Kapitel der Dokumentation.
Ausbreitung von Gasen und Schadstoffen, Brunnenabsenkung, lineare Netze für Gleichstrom-Lastfluss, Wärme und Rohrleitungen, Nachlauf in Windparks, Ermüdung nach Rainflow und Miner, Schadenaggregation nach Panjer, räumliche Zufallsfelder, Linienintegrale durch Raster und exakte lineare Dynamik.
Punkte, Linien, Polygone, Polyeder, Raster, Netze und FEM- oder CFD-Gitter mit Koordinatensystemen und geprüften Einheiten. Messreihen mit Nachweisgrenzen, Windrosen und Rasterdaten werden direkt gelesen.
Schwere Ränder, zirkuläre Verteilungen für Richtungen, Mischungen, Copulas für gemeinsame Extreme und zeitliche Prozesse wie Ornstein-Uhlenbeck oder autoregressive Modelle.
Parameter werden gegen Beobachtungen geschätzt, auch zensierte und fehlende Werte. Parameterunsicherheit, Profil-Likelihoods und auf Wunsch vollständige Posteriorverteilungen mit NUTS gehören dazu.
Weil das ganze Modell differenzierbar ist, werden Standorte, Leitungsverstärkungen, Dosierungen oder Selbstbehalte direkt gegen das erwartete oder das Extremrisiko optimiert, auch mit Nebenbedingungen.
Jede Kennzahl kommt mit ihrem Monte-Carlo-Fehler. Quantile, VaR und CVaR sind für jede Größe verfügbar, Aggregatverluste auch exakt ohne Stichprobenrauschen.
Lokale Ableitungen, Elastizitäten, Sobol-Indizes und Shapley-Werte für Varianz und Extremrisiko zeigen, welche Eingangsgröße wie viel des Risikos trägt.
WAIC, PSIS-LOO, PIT-Kalibrierung, CRPS und Posterior-Predictive-Checks sagen, ob ein Modell zu den Daten passt, bevor Entscheidungen darauf beruhen.
Neuronale Netze und Baumensembles lernen, was niemand als Formel aufgeschrieben hat, etwa eine Leistungskurve aus SCADA-Daten. Bekannte Physik geht als Physik-Schicht in das Netz ein, und das Surrogat wird im Modell zusammen mit allen physikalischen Parametern weiter kalibriert.
Surrogate lernen ganze Vorhersageverteilungen mit Quantil-, Gauß-, Mischungs- oder Histogrammköpfen, trainiert mit strikt richtigen Bewertungsregeln wie CRPS, und mit Rändern, die über den gelernten Bereich hinaus definiert bleiben.
Ein ganzes Modell wird in ein schnelles Surrogat übersetzt, das gegen den Monte-Carlo-Fehler des Modells selbst geprüft wird. Anfragen außerhalb des trainierten Bereichs, nahe an einer Entscheidungsschwelle oder bei uneinigen Ensemblemitgliedern gehen automatisch an das volle Modell, und jeder Rückfall wird protokolliert.
Ergebnisse sind auf CPU und GPU bitgleich. Modellpakete speichern ein Protokoll jeder Rechnung, und exportierte Surrogate laufen über eine C-Bibliothek ohne Python, etwa in Leitsystemen.
Jedes Beispiel ist ein vollständiges Modell aus unserer Dokumentation, und jede Abbildung stammt direkt daraus. Alle Daten sind synthetisch, es sind keine Kundendaten.
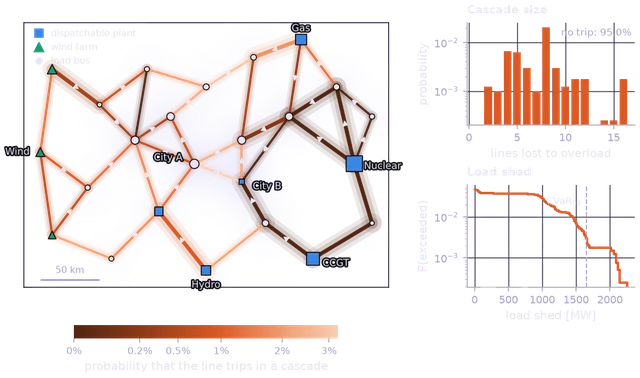
PTDF und LODF aus dem Gradienten des Gleichstrom-Lastflusses, N-1-Analyse unter unsicherem Wind und unsicherer Last, kaskadierende Überlastabschaltungen mit Lastabwurf und per Gradient optimierte Leitungsverstärkungen.
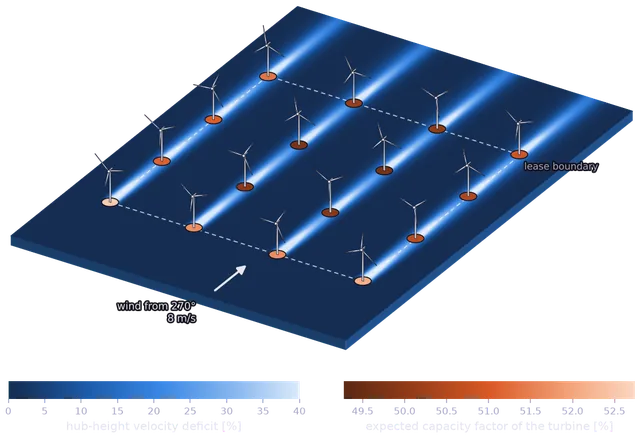
Beispiel ansehenBlattelementimpulstheorie für den Rotor, eine gerichtete Windklimatologie, Nachlaufverluste im Park, die Verteilung des Jahresertrags mit P50 und P90 und ein per Gradient optimiertes Layout.
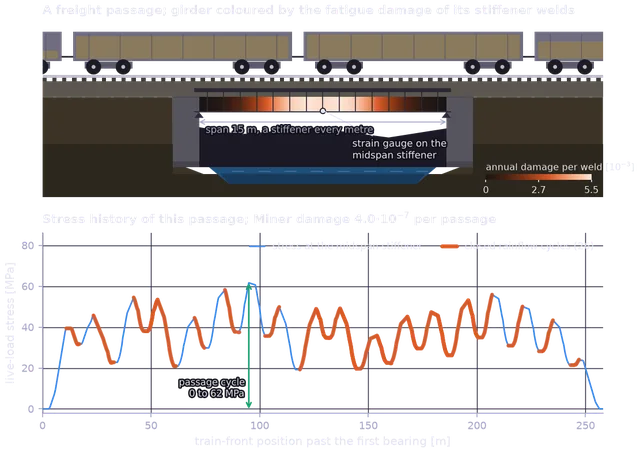
Beispiel ansehenRainflow-Zählung und Miner-Schädigung einer Brückenschweißnaht unter zufälligem Zugverkehr, kalibriert an Dehnungsmessungen, mit der Versagenswahrscheinlichkeit über 100 Jahre und einer per Gradient ausgelegten Flanschdicke.
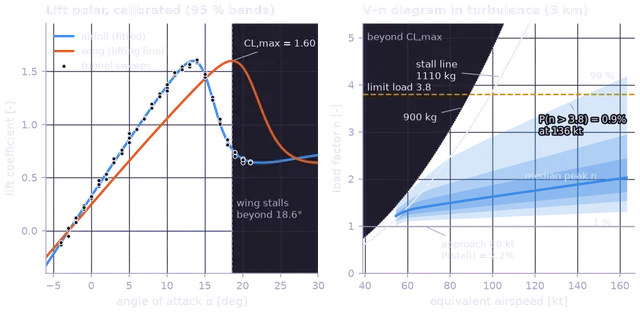
Beispiel ansehenEine an Windkanaldaten kalibrierte Auftriebspolare, geflogen durch zufällige Turbulenz: die Wahrscheinlichkeit eines Strömungsabrisses im Anflug und einer Überschreitung des Lastvielfachen im V-n-Diagramm.
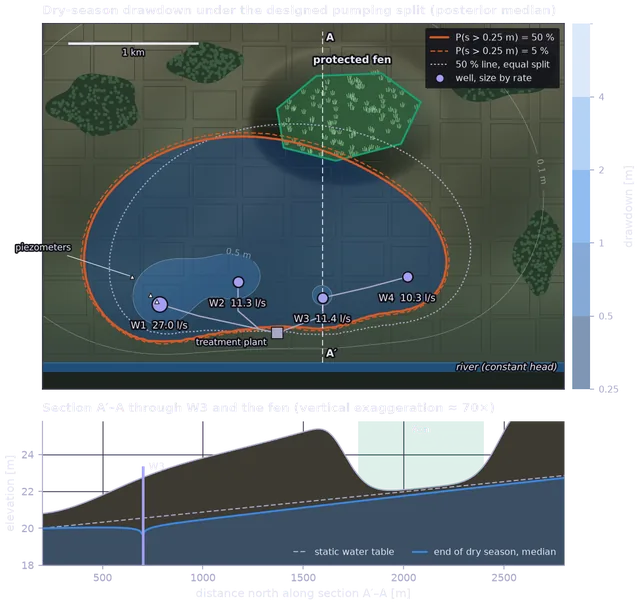
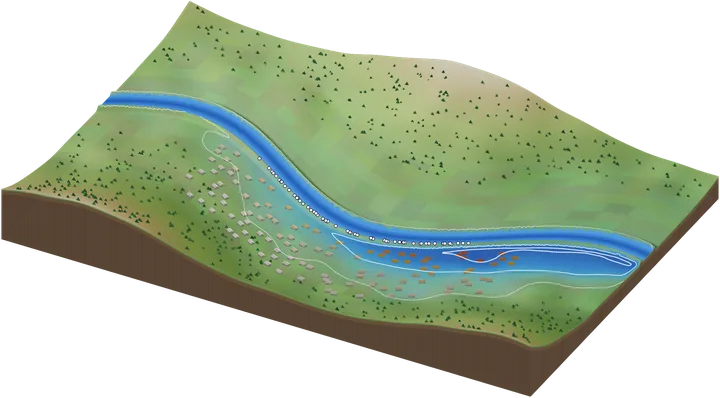
Beispiel ansehenTheis-Absenkung eines Brunnenfelds neben einem geschützten Niedermoor, kalibriert an einem Pumpversuch, mit Förderraten, die den Bedarf bei einer Wahrscheinlichkeitsnebenbedingung für das Moor decken.
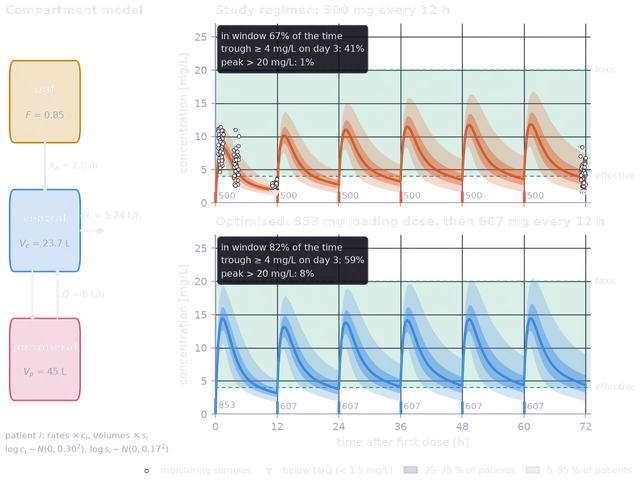
Beispiel ansehenEin exaktes Kompartimentmodell lernt die Variabilität zwischen Patienten aus wenigen, teils unter der Nachweisgrenze liegenden Proben, und Aufsättigungs- und Erhaltungsdosis werden per Gradient ausgelegt.
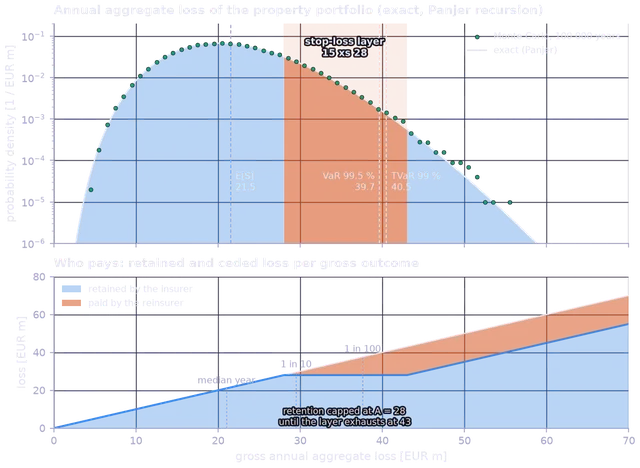
Beispiel ansehenDie exakte Verteilung des Jahresaggregatschadens nach Panjer, Preis einer Stop-Loss-Schicht, Kapitalgradienten, ein optimaler Selbstbehalt und ein Abgleich mit Monte Carlo und Copulas.
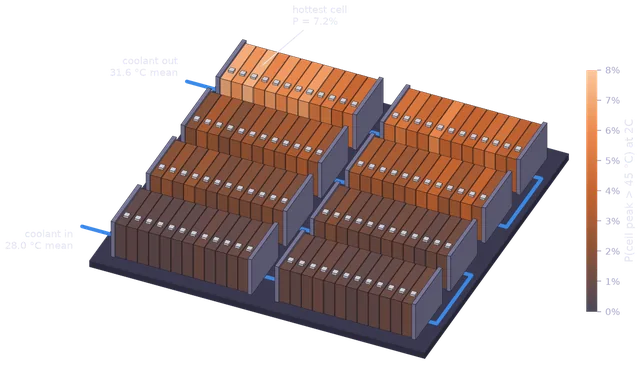
Beispiel ansehenEin physikinformiertes Netz ersetzt ein thermisches Batteriemodell im Risikomodell eines Packs, wird an Flottendaten nachkalibriert und legt fest, wie schnell der Pack laden darf.
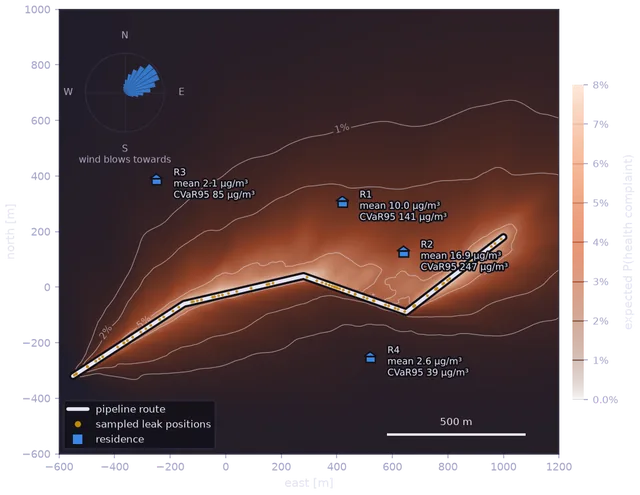
Beispiel ansehenEine Gasfahne aus einem Leck an beliebiger Stelle einer Pipeline, Wind als Zufallsgröße, Exposition und ihr Extremwert an jedem Wohnhaus und eine per Gradient optimierte Minderungsmaßnahme.
Beispiel ansehenDieselben Bausteine tragen sehr unterschiedliche Fragestellungen. Hier die häufigsten, mit dem Einstieg in die Dokumentation.
prophys ist eine Python-Bibliothek, in der ein Wahrscheinlichkeitsmodell aus Geometrie, Physik und Verteilungen zusammengesetzt und als ein JAX-Graph ausgewertet wird, mit Monte Carlo, Kalibrierung und Export.
Vorwärtspropagation von Eingangsunsicherheit, Parameterunsicherheit aus Kalibrierung, Monte-Carlo-Fehler jeder Kennzahl und Sobol-Sensitivitäten, alles aus demselben Modell.
Solver-Ergebnisse auf Gittern und Rastern werden differenzierbare Eingaben, Messreihen kalibrieren das Modell laufend nach, und exportierte Surrogate laufen im Betrieb ohne Python.
Netze, Baumensembles und Neural Operators, vortrainiert auf eigenen Daten, mit Physik-Schichten, Unsicherheit und Extrapolationswächtern, und operative Surrogate mit automatischer Rückfallebene.
Ausfallwahrscheinlichkeiten, Ermüdung, Verfügbarkeitsmodelle als Markov-Ketten, Extremrisiko als VaR und CVaR und die Frage, welche Anlage wie viel dazu beiträgt.
Gleichstrom-Lastfluss, PTDF und LODF, N-1-Bewertung unter unsicherer Einspeisung und Last, Kaskaden und die Optimierung von Verstärkungen gegen das Extremrisiko des Lastabwurfs.
Vom Blattprofil zum P90: Rotoraerodynamik, Windklima, Nachlauf, Verfügbarkeit und ihre Anteile an der Unsicherheit des Jahresertrags.
Ermüdung von Brücken und Schienen, Störungen, die sich über ein Netz fortpflanzen, und die Wahl von Inspektions- und Instandhaltungsmaßnahmen nach ihrer Wirkung auf das Risiko.
Frequenz-Schadenhöhe-Modelle mit exakter Aggregatverteilung, schwere Ränder, Copulas für gemeinsame Extreme und Preis und Kapital von Rückversicherungsschichten mit exakten Gradienten.
Generische Vorhersagemodelle für Tabellendaten und reine Black-Box-Surrogate sind stark, wenn es um eine Punktvorhersage aus vielen Beispielen geht. Viele technische Entscheidungen brauchen etwas anderes.
Anders als generische Black-Box-Ansätze trägt ein prophys-Modell die Physik selbst: Ausbreitung, Lastfluss oder Ermüdung sind Bausteine des Modells. Dadurch bleibt es außerhalb der Trainingsdaten plausibel und braucht oft wenige Messungen.
Statt einer Zahl liefert prophys eine Verteilung mit Quantilen, VaR und CVaR, den Monte-Carlo-Fehler jeder Kennzahl und Kalibrierungsprüfungen wie PIT und CRPS, damit Extremfälle belastbar beziffert werden.
Gradienten fließen durch Geometrie, Physik, Verteilungen und Surrogate. Kalibrierung, Sensitivität und Auslegungsoptimierung nutzen dieselbe exakte Ableitung, statt ein Modell von außen abzutasten.
Ein operatives Surrogat wird gegen das volle Modell validiert und gibt Anfragen, bei denen es unsicher ist oder den trainierten Bereich verlässt, automatisch an das volle Modell zurück, mit Protokoll.
Netzpotenziale, Green-Funktionen, Rainflow-Zählung, Panjer-Rekursion, Kalman-Likelihood und räumliche Zufallsfelder sind fertige, exakt differenzierbare Bausteine, die sich zu neuen Modellen kombinieren lassen.
Jede Rechnung hinterlässt ein Protokoll, Ergebnisse sind auf CPU und GPU bitgleich, und Diagnosen mit festen Codes melden Formfehler und unvollständige Trainingsläufe.
prophys ist unser eigenes Werkzeug. Wir setzen es in Projekten ein und helfen Ihren Teams, selbst damit zu modellieren.
Ein gemeinsamer Workshop an einem Ihrer Probleme: vom ersten Modell über Kalibrierung bis zur Risikokennzahl, mit Code, den Ihr Team weiterführen kann.
Wir bauen das Modell Ihres Systems mit Ihren Fachleuten, prüfen es an Ihren Daten und liefern es als Paket mit Dokumentation und Übergabe.
Wir trainieren und validieren schnelle Surrogate Ihrer Modelle für den Betrieb, mit Rückfallebene, Abnahmeprotokoll und Anbindung an Ihre Systeme.
Begleitung bei Methodik, Modellprüfung und Weiterentwicklung, sowie Lizenzen für Modelle über die kostenlose Stufe hinaus.
Ein Modell mit bis zu 250 strukturellen Objekten insgesamt, etwa Punkte, Polygonecken, Liniensegmente oder Rasterzellen, läuft ohne Lizenz. Monte-Carlo-Stichproben, Beobachtungen und Trainingsschritte zählen nie mit. Alle Beispiele der Dokumentation laufen in dieser Stufe.
prophys ist eine Python-Bibliothek von RhineQC für probabilistische Physikmodelle. Geometrie, Physik, Unsicherheit und gelernte Surrogate werden in einem differenzierbaren Modell zusammengesetzt, das simuliert, kalibriert und optimiert werden kann.
Generische Modelle lernen eine Punktvorhersage aus Beispielen. prophys bildet die Physik eines Systems explizit ab, propagiert Unsicherheit durch sie hindurch und liefert kalibrierte Verteilungen mit Extremrisiken und exakten Gradienten.
Nicht für kleine Modelle: bis zu 250 strukturelle Objekte je Modell sind kostenlos, unabhängig von der Zahl der Monte-Carlo-Stichproben und Beobachtungen. Größere Modelle und einige Surrogatfunktionen benötigen eine Lizenz von RhineQC.
Ja, mit der GPU-Ausgabe von prophys. Die Ergebnisse sind auf CPU und GPU bitgleich, sodass ein auf dem Laptop kalibriertes Modell auf einem GPU-Server exakt dieselben Zahlen liefert.
Ja. Modelle werden als Pakete mit Protokoll exportiert, Surrogate laufen über eine C-Bibliothek ohne Python, und operative Surrogate geben unsichere Anfragen automatisch an das volle Modell zurück.
Schildern Sie uns die Entscheidung und die Unsicherheit dahinter. Wir zeigen Ihnen in einem kurzen Gespräch, wie ein prophys-Modell dafür aussähe.